Come funzionano i grandi modelli linguistici, perché fidarsi ciecamente è un errore e cosa cambia per la privacy tra cloud e uso locale.
Di Marvin Pascale
Apri una chat, fai una domanda e ricevi una risposta impeccabile. Frasi ordinate, tono sicuro, magari una tabella e qualche riferimento. Tutto sembra suggerire che dall’altra parte ci sia qualcuno che sa esattamente di cosa sta parlando.
Poi controlli una fonte. E scopri che non esiste.
È una situazione possibile, non un buon motivo per buttare via questi strumenti. È invece un ottimo motivo per capire come funzionano. Perché il problema non è soltanto quello che un modello linguistico può sbagliare: è quello che noi siamo disposti a credere quando ce lo racconta bene. (openai.com)
E c’è una seconda domanda, spesso dimenticata: mentre gli chiediamo di aiutarci, quali informazioni gli stiamo consegnando?
Prima precisazione: un LLM è intelligenza artificiale
Mettiamo subito in ordine i termini. Dire «non è intelligenza artificiale, è un LLM» sarebbe scorretto. Un LLM è una forma di intelligenza artificiale. Non tutta l’intelligenza artificiale, però, è un LLM. La sigla significa Large Language Model, cioè grande modello linguistico: un sistema addestrato su grandi quantità di dati per elaborare e generare linguaggio. (ibm.com)
È una distinzione pratica, non una gara a chi conosce più sigle. Se chiamiamo tutto semplicemente «AI», rischiamo di attribuire a strumenti diversi le stesse capacità e gli stessi limiti.
Va distinta anche l’applicazione dal modello. ChatGPT e gli altri assistenti sono prodotti che utilizzano modelli e possono integrarli con strumenti aggiuntivi, come la ricerca sul web o l’accesso a documenti. Il modello è una componente del sistema, non necessariamente tutto quello che vediamo nella chat. (ibm.com)
Come fa a costruire una risposta?
Il punto di partenza è l’addestramento. Il modello analizza enormi quantità di dati. Un esercizio fondamentale consiste nel prevedere parti di testo e correggere progressivamente le previsioni attraverso operazioni matematiche. A cambiare sono i suoi parametri: numeri che regolano il modo in cui elabora le informazioni. In questo processo apprende strutture del linguaggio e relazioni tra parole, concetti e contesti. (developers.google.com)
Quando gli scriviamo, il testo viene suddiviso in piccole unità chiamate token: parole intere, parti di parole o simboli. Nei modelli generativi usati comunemente nelle chat, la risposta viene costruita progressivamente, selezionando i token successivi sulla base del contesto e delle relazioni apprese. Non è, quindi, una semplice ricerca in un archivio di risposte già pronte. (ibm.com)
Molti LLM usano un’architettura chiamata Transformer, capace di valutare le relazioni tra diverse parti del testo. Ulteriori fasi di addestramento possono migliorare la capacità di seguire istruzioni e svolgere compiti specifici. (developers.google.com)
Ridurre tutto a «indovina la prossima parola» descrive una parte del meccanismo, ma non rende giustizia alle capacità che ne derivano: tradurre, sintetizzare, scrivere codice, affrontare problemi. Il limite da ricordare è un altro: saper costruire una risposta non equivale a garantirne la verità. (ibm.com)
Un dettaglio importante: usare ciò che scriviamo come contesto non significa, di per sé, riaddestrare il modello in tempo reale. Il fatto che un servizio conservi la conversazione o la utilizzi successivamente per migliorare i modelli è una questione distinta, regolata dalle sue condizioni e impostazioni. (developers.google.com)
Il problema non è solo quando sbaglia. È quando sbaglia bene.
Immaginiamo di chiedere tre libri su un argomento. L’assistente potrebbe restituire titoli, autori e descrizioni perfettamente credibili, includendo un libro inesistente. Questo tipo di contenuto plausibile ma falso viene comunemente chiamato allucinazione. Può riguardare anche date, citazioni, riferimenti bibliografici e spiegazioni. (openai.com)
Non serve attribuire al sistema un’intenzione di mentire per riconoscere il problema. Per chi legge, un’informazione inventata rimane inventata, anche quando è presentata con grande cortesia.
E l’errore non deve essere spettacolare per fare danni. Pensiamo a un riassunto ipotetico che trasforma «potrebbe verificarsi» in «si verificherà», oppure elimina l’eccezione che cambia il significato di una clausola. Il testo può diventare più scorrevole e, contemporaneamente, meno fedele.
Oltre alle invenzioni, esistono informazioni incomplete e distorsioni presenti nei dati. Fidarsi senza controllare amplifica questi rischi: una risposta sbagliata diventa una decisione sbagliata. (genai.owasp.org)
Il tono autorevole non è un certificato di correttezza. E una tabella ben impaginata non diventa vera per meriti estetici.
Verificare non significa chiedergli: «Sei sicuro?»
Chiedere un controllo aggiuntivo può essere utile, ma non costituisce una verifica indipendente. La conferma dello stesso assistente non dovrebbe essere l’unica prova sulla quale basare una decisione.
Quando conta l’accuratezza, bisogna uscire dalla chat: aprire la fonte, controllare che esista e verificare che sostenga davvero l’affermazione. La presenza di un riferimento non basta. Anche il collegamento a documenti o informazioni esterne può migliorare le risposte senza renderle infallibili. (openai.com)
La domanda utile è: che cosa succede se questa risposta è sbagliata?
Per trovare un titolo creativo, possiamo tollerare molti tentativi. Per interpretare un referto, prendere una decisione economica o stabilire se firmare un contratto, il livello di controllo deve essere diverso. In questi casi userei l’assistente per preparare domande e chiarire termini, non come unico decisore. (cnil.fr)
L’obiettivo non è ricontrollare ogni virgola. È concentrare l’attenzione dove un errore avrebbe conseguenze reali.
Quando l’assistente può agire, il rischio cambia
Un conto è ricevere una bozza. Un altro è autorizzare un sistema ad accedere alla posta, modificare documenti o eseguire operazioni.
Esiste un attacco chiamato prompt injection: istruzioni manipolative inserite, per esempio, in una pagina web o in un documento che l’assistente deve leggere. Il sistema può essere indotto a trattarle come comandi, invece che come semplice contenuto. Le conseguenze dipendono dai dati e dagli strumenti ai quali ha accesso. (genai.owasp.org)
Per questo conviene concedere soltanto i permessi necessari e richiedere una conferma prima delle operazioni delicate. Far preparare un’email non è la stessa cosa che autorizzarne l’invio. La comodità dell’automazione non dovrebbe cancellare questa distinzione. (genai.owasp.org)
Privacy: il documento che incolli non è una chiacchiera innocua
Immaginiamo una persona che riceve un contratto riservato e lo carica in un assistente per ottenere un riassunto. Il documento contiene nomi, importi, condizioni commerciali e informazioni su un cliente.
L’intenzione è risparmiare tempo. Ma la domanda da porsi viene prima del caricamento: questo strumento è adatto a trattare queste informazioni?
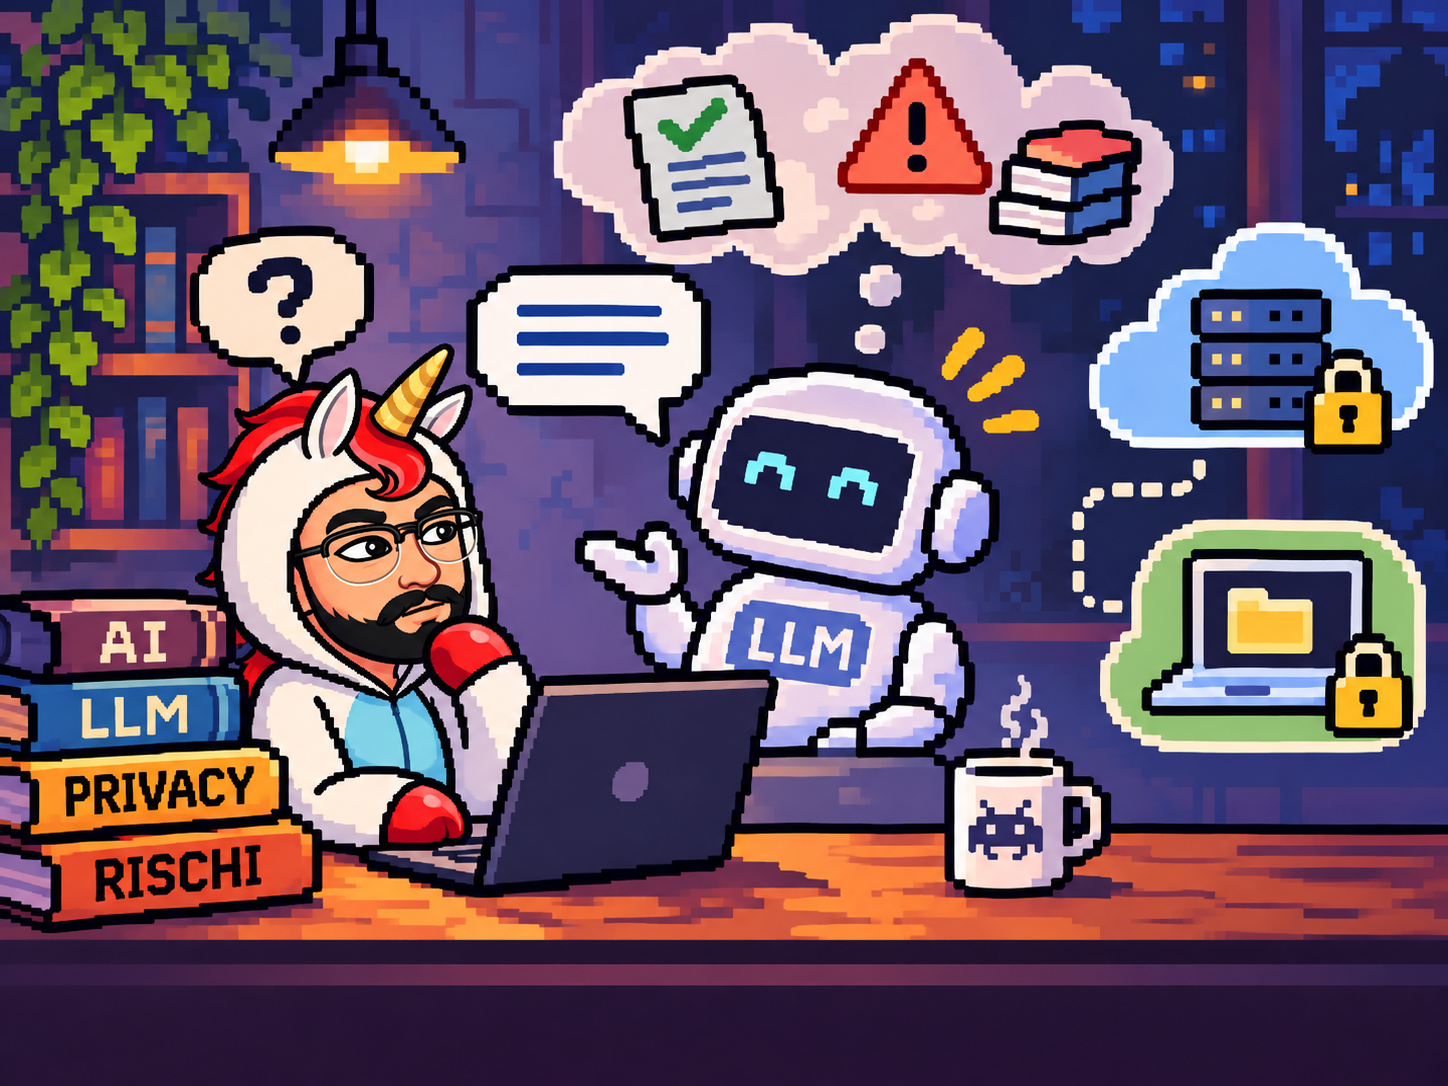
Con un servizio in cloud, i contenuti inviati vengono elaborati su infrastrutture esterne al nostro dispositivo. È comodo perché non dobbiamo gestire direttamente tutta l’infrastruttura, ma richiede una valutazione del servizio e delle sue garanzie. (cnil.fr)
Qui occorre distinguere tre cose. Elaborazione significa usare i dati per svolgere la richiesta. Conservazione significa mantenerne una copia, per esempio nella cronologia o nei sistemi del servizio. Addestramento significa utilizzarli per modificare o migliorare un modello. Un servizio può escludere i contenuti dall’addestramento e conservarli comunque. (help.openai.com)
Quindi «i tuoi dati non vengono usati per addestrare i modelli» è un’informazione importante, ma non risponde a tutte le domande sulla privacy.
Le condizioni possono cambiare tra servizi personali e aziendali, anche dello stesso fornitore. Possono esistere controlli sull’uso dei dati e sulla conservazione, con limiti ed eccezioni specifici. Aver pagato un abbonamento, da solo, non dimostra che sia il servizio giusto per i documenti dell’azienda. (help.openai.com)
Prima di inviare contenuti riservati, vorrei sapere chi può accedervi, dove vengono trattati, per quanto tempo rimangono conservati e quali condizioni si applicano alle funzioni utilizzate. Non mi basterebbe un generico «privacy garantita» sulla pagina commerciale.
Locale: più controllo, non sicurezza per magia
Un modello locale viene eseguito sul nostro computer o su un server della nostra organizzazione. Con un sistema interamente locale, anche l’analisi dei documenti può avvenire senza inviarli a un fornitore esterno. Dopo aver procurato software e modelli necessari, alcune soluzioni possono funzionare anche senza connessione a Internet. (lmstudio.ai)
È una possibilità importante per chi lavora con informazioni riservate. Ma «ho installato un’app sul computer» non significa automaticamente «tutto rimane sul computer»: esistono applicazioni che combinano modelli locali, modelli remoti e ricerca online. Bisogna verificare quali funzioni siano effettivamente attive. (docs.ollama.com)
Anche in una configurazione tutta locale resta da proteggere ciò che abbiamo in casa: dispositivo, account, conversazioni salvate, documenti e copie di sicurezza. Un archivio riservato accessibile a chiunque sul computer condiviso non diventa protetto perché l’LLM lavora offline.
Il controllo locale comporta inoltre gestione, aggiornamenti e risorse di calcolo. Modelli più piccoli possono ridurre le risorse necessarie, con compromessi da valutare sulle attività reali. La scelta non dovrebbe basarsi soltanto sul numero di parametri o sulla promessa di prestazioni eccezionali. (developers.google.com)
E soprattutto: locale non significa più corretto. Tenere i dati sul proprio computer riguarda la riservatezza; verificare le risposte riguarda l’affidabilità. Sono problemi diversi, e risolverne uno non risolve automaticamente l’altro. (openai.com)
Cloud o locale? Dipende dal lavoro, non dalla tifoseria
Non sceglierei in base a uno slogan. Partirei da tre domande: quali dati devo usare, quale risultato mi serve e quali conseguenze avrebbe un errore?
Per lavorare su contenuti pubblici, un servizio cloud può essere una scelta pratica. Per documenti riservati occorre invece valutare garanzie contrattuali, accessi e controllo dell’infrastruttura. In alcuni casi sarà adeguato un servizio aziendale; in altri sarà preferibile una soluzione locale. La scelta deve seguire il caso d’uso e la sensibilità dei dati. (cnil.fr)
Nulla vieta di adottare un criterio diverso per attività diverse: strumenti esterni per contenuti pubblici, ambienti più controllati per quelli riservati. L’importante è stabilire il confine prima di caricare i documenti, non dopo.
Usarli bene significa restare al comando
Non serve diventare esperti di reti neurali. Serve qualche abitudine concreta.
Condividere il minimo necessario. Per riscrivere una frase non serve allegare l’intero fascicolo del cliente. Quando basta un esempio, meglio inventarlo anziché usare dati reali.
Verificare ciò che ha conseguenze. Nomi, cifre, date, citazioni e passaggi decisivi meritano un controllo sulle fonti originali. Un riassunto importante va confrontato con il documento di partenza.
Decidere che cosa non delegare. Accessi, invii, modifiche e decisioni delicate richiedono confini chiari. Sul lavoro, la scelta degli strumenti dovrebbe essere condivisa con chi gestisce sicurezza e protezione dei dati, non lasciata all’iniziativa del singolo.
Gli LLM possono essere ottimi strumenti di lavoro. Non devono essere perfetti per essere utili. Ma non dovrebbero diventare autorevoli soltanto perché rispondono con sicurezza.
Una risposta convincente non è necessariamente corretta. Un servizio comodo non è automaticamente adatto ai nostri dati. E spostare l’elaborazione sul proprio computer non elimina il bisogno di controllare il risultato.
Un LLM può aiutarci a pensare. Non dovrebbe diventare una scusa per smettere di farlo.